Qwen3.8-27B uncensored はどれを選ぶ?第三者鑑定が比較した12版
Qwen3.8-27B uncensored の派生モデルは加工元で中身が大きく異なります。第三者鑑定 Abliterlitics が検証した 12 版の拒否率・回答完了率・KL ダイバージェンスを比較し、おすすめの版、避けるべき版、失敗しない選び方の手順まで整理します。
この記事の要点
- 同じ Qwen3.8-27B でも加工元ごとに仕上がりが異なり、総合最良は orcarouter 版、base に最も近いのは apostate 版です。
- 過剰改変の OBLITERATUS 版や隠し指示のある Blackfrost 版など、注意・回避すべき版があります。
- 「従う割合」と「最後まで答える割合」の乖離に着目し、5 つの確認手順で見分けます。
目次
- 0. Qwen3.8-27B の uncensored 版とは何か?
- ベースとなる Qwen3.8-27B の基本性能と拒否の強さ
- abliteration は重みをどう改変するのか?
- 第三者プロジェクト Abliterlitics による一斉鑑定
- 1. 第三者鑑定はどの版を高く評価したか?
- 総合最良と判定された orcarouter 版
- base に最も近い apostate 版(旧 heterodoxin)
- 原型を最も保つ trohrbaugh 版
- 追試組の rvn 版と apostate_diode 版
- 2. 避けるべき版や注意が必要な版はどれか?
- 改変しすぎて知能が低下した OBLITERATUS 版
- ひな形に脱獄指示を隠していた Blackfrost-AI 版
- 真実性が低下した aggressive 領域の版
- 3. 「従う」と「最後まで答える」は何が違うのか?
- harmful-only と delivered の開き
- 4. 鑑定の数字はどう読めばよいか?
- KL ダイバージェンスの並びと意味
- モデルカードの主張と第三者実測のズレ
- 著作権に関わる出力は全版で制限が残る
- 12 版の比較一覧
- 測定条件に関する但し書きと一次ソース
- 5. 自分で見分けるにはどうすればよいか?
- Deepent Research について
- よくある質問
- 免責
Hugging Face や Ollama で Qwen3.8-27B の検閲解除版(uncensored や abliterated と名付けられたモデル)を探すと、
同じベースから作られた派生版が何種類も並び、
どれを使えばよいのか迷います。
モデル名や説明文だけでは、加工の手順も出来の違いも分かりません。
第三者の鑑定では、12 版の出来が大きく分かれました。
総合で最良とされた版がある一方で、
改変しすぎた版では回答の約半分が思考のまま止まり、
答えが出力されませんでした。
この記事では、第三者検証プロジェクト Abliterlitics の鑑定データをもとに、
どの版を使い、どの版を避けるべきかと、
自分で見分ける手順を整理します。
0. Qwen3.8-27B の uncensored 版とは何か?#
Qwen3.8-27B の uncensored 版とは、
元のモデルの重み(学習で決まった数値パラメータ)から、
回答を拒否する働きを直接取り除いて作られた派生モデルです。
新しい知識や推論能力を足す加工ではなく、
拒否する働きだけを外します。
ベースとなる Qwen3.8-27B の基本性能と拒否の強さ#
ベースの Qwen3.8-27B は、
Alibaba が 2026 年 8 月 14 日に公開した、
約 27B(270 億)パラメータのオープンウェイト(重みが公開された)モデルです(Qwen3.8-27B 配布ページ)。
内部は 64 層の構成で、
48 層の Mamba2 線形注意と 16 層の全注意(full attention)を組み合わせています。
テキストに加え、画像や動画の入力に標準で対応し、
文脈長は最大 262,144 トークン(提供時は 16,384 トークン)、
語彙数は 248,320 です。
一方で、公式モデルは有害な要求にほとんど応じません。
ベンチマークの有害要求 400 件を投入した検証で、
本家モデルが回答に応じたのは 18 件(4.5%)だけでした。
本家の拒否は悪用を防ぐための安全策ですが、
医学や薬学の調査、法学の事例研究、
情報セキュリティの検証といった専門的な場面では、
正当な質問まで遮断されてしまいます。
この制限を外すために、
コミュニティの開発者から独自の解除版が相次いで公開されました。
abliteration は重みをどう改変するのか?#
abliteration は、
モデルの重みから拒否する方向を表す数値のベクトルを特定し、
引き算して取り除く加工技術です。
再学習を行わずに、拒否の挙動だけを取り除けます。
参考: 「拒否しない AI」はどうやって作るのか——abliteration をやさしく解説
参考: Qwen3.8-27B abliterated は加工元でどう違う?4 系統の比較と選び方
第三者プロジェクト Abliterlitics による一斉鑑定#
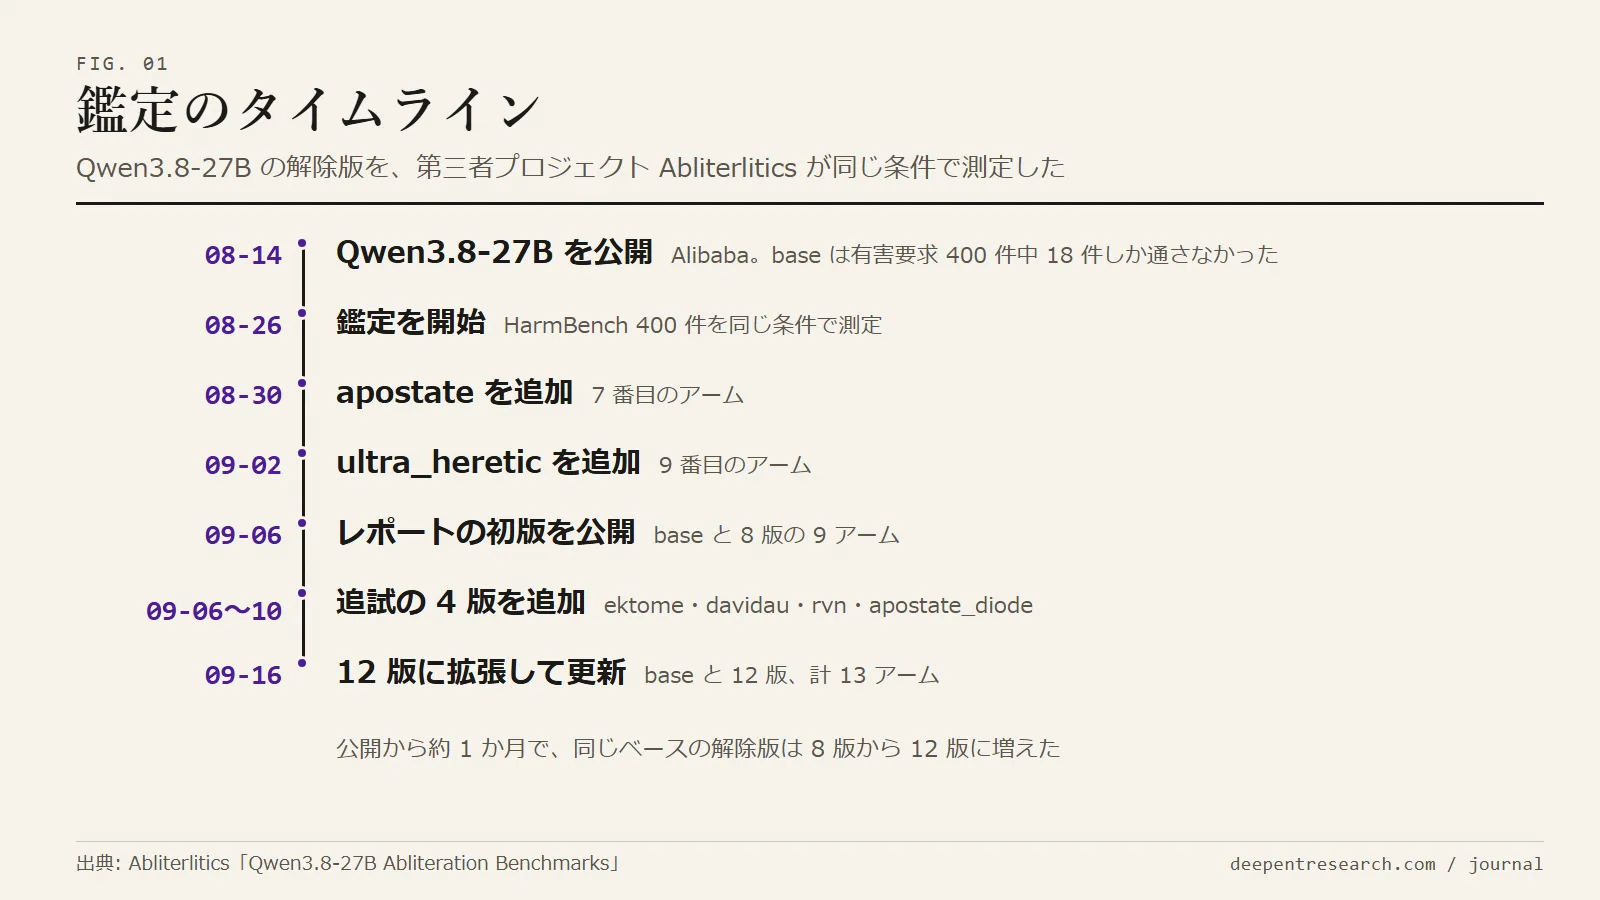
第三者検証プロジェクトの Abliterlitics が、
Qwen3.8-27B の解除版を一斉に鑑定しました(Abliterlitics レポート)。
当初は base と 8 版の 9 アームで始まり、
公開後に ektome・davidau・rvn・apostate_diode の 4 版が追加されて、
現在は base と 12 版を合わせた計 13 アームです。
計算資源は、
当初の 167 GPU 時間と追加分の 166 GPU 時間を合わせて約 333 GPU 時間でした。
能力の測定には、
Open LLM Leaderboard v2 や GSM8K、
TruthfulQA、HumanEval、
LAMBADA など 13 種類の評価タスク(ベンチマーク)が使われました。
HarmBench の 400 件の有害要求(15,360 トークン、温度 0)に対する全推論ログは、
評価モデルの glm-5.3-flash が 4 つの分類(no_refusal、soft_refusal、refusal、degenerate)で判定し、
合計 5,200 件の判定結果が記録されています。
さらに、重みの差分解析で、
どの層がどれだけ改変されたかを調べ、
加工後のモデルが元のモデルからどれだけずれたかを示す KL ダイバージェンス(小さいほど元に近い)も測っています。
1. 第三者鑑定はどの版を高く評価したか?#
第三者鑑定の結果は、
大きく改変した版よりも、
小さく丁寧に編集した版のほうが出来がよいというものでした。
総合最良と判定された orcarouter 版#
総合評価で最も高いスコアだったのは、
orcarouter/Qwen3.8-27B-Uncensored です。
手法には、古典的な単一方向除去(Arditi 2024, k=1)を採用しています。
改変したテンソル(重みのまとまり)は 129 個で、
KL ダイバージェンスは 0.0676 でした。
自動判定による攻撃成功率(judge ASR)は 82.2%、
有害要求に従う割合(harmful-only)は 96.7% です。
配布ページの説明(モデルカード)に書かれた 4 項目の主張は、
第三者の検証ですべて一致しました。
歌詞や書籍本文の引用といった著作権に関わる出力でも、
13 アーム中で最良の 39% でした。
推論能力を保ったまま幅広い調査をしたい人は、
まずこの版から試すとよいでしょう。
base に最も近い apostate 版(旧 heterodoxin)#
編集が最小で、base の数値に最も近かったのが、
heterodoxin/qwen-3.8-27b-abliterated です。
apostate という別名でも呼ばれ、以下ではこの名で書きます。
この版は KCRN と呼ばれる手法を用い、
41 箇所の実編集(すべて rank-1)だけで解除しています。
KL ダイバージェンスは 0.0439、
judge ASR は 78.7%、
harmful-only は 95.0% です。
ただし、利用環境には注意が必要です。
画像や動画を処理する視覚塔と、
高速化のための MTP ドラフトヘッドを省いた、テキスト専用の構成です。
配布形式もファイルサイズの大きい FP16 で格納されており、
正常に動かすには設定ファイルの上書きが必要です。
環境設定に慣れていて、
base モデルの挙動をできるだけ崩さずにテキスト推論をしたい上級者に向いています。
原型を最も保つ trohrbaugh 版#
能力を最も原型どおりに保ち、拒否も意図的に残したのが、
trohrbaugh/Qwen3.8-27B-heretic-ara です。
加工ツール Heretic の ARA 方式で、60 個のテンソルを編集しています。
実測の KL ダイバージェンスは 0.0586 で、
モデルカードに記載された 0.0535 との差は 1.1 倍でした。
KL ダイバージェンスのカード記載値と実測値がほぼ一致したのは、
全版の中でこの版だけです。
judge ASR は 57.5% で、
有害要求 400 件中 122 件には意図的に拒否を残しています。
トークン上限で途切れる割合は 14.8% で、全解除版の中で最少でした。
拒否を完全に外すことより、
思考がループせず最後まで回答が届くことを重視する人に向いています。
追試組の rvn 版と apostate_diode 版#
初期の鑑定後に追試として追加された 4 版のうち、
rvn 版は、trohrbaugh 版をベースに ARA の加工を 2 パス重ねた版です。
実編集は 60 箇所で、
KL ダイバージェンスは 0.0837 でした。
apostate_diode 版は、
条件付き解除(conditional abliteration)という手法を採用しています。
MLP(多層パーセプトロン)の層 14〜48 にあたる 35 層へ、
検出器で開閉するニューロン(gated neuron)を 1 個ずつ追加する設計で、
既存の重みは削りません。
実測の KL ダイバージェンスは全版で最小の 0.0389 で、
harmful-only は 94.7% です。
編集の大きさは 3 つの階層に分かれます。
階層は KL ダイバージェンスと加工手法による分類で、上位は最小級の編集に集中し、841 個を改変した OBLITERATUS は最下位になりました。
| 階層 | KL ダイバージェンス | 版(改変テンソル数) |
|---|---|---|
| 外科的(Surgical) | 0.04〜0.07 | trohrbaugh(60)、apostate_diode(41)、orcarouter(129) |
| 標準(Standard) | 0.05〜0.08 | huihui-ai(70)、coder3101(88) |
| 強引(Aggressive) | 0.17〜1.54 | ultra_heretic(99)、Blackfrost-AI(124)、OBLITERATUS(841) |
テンソル数は 850 個の LM テンソルのうちの改変数です(出典: Abliterlitics)。
12 版の全数値は記事末尾の「12 版の比較一覧」にまとめています。
2. 避けるべき版や注意が必要な版はどれか?#
避けるべき版は、
改変しすぎて回答の約半分が思考のまま止まる OBLITERATUS 版です。
Blackfrost-AI 版は、
会話のひな形(chat template)に脱獄用の指示が隠されており、
注意が必要です。
改変しすぎて知能が低下した OBLITERATUS 版#
避けるべき版は、
OBLITERATUS/Qwen3.8-27B-OBLITERATED です。
この版は全体の 98.9% にあたる 841 個のテンソルを改変しており、
KL ダイバージェンスは 1.5427 に達しました。
judge ASR は 63.9% で、
12 版の中で下から 2 番目です。
最大の問題は、回答の約半分が正常に出力されない点です。
思考モードに入ったまま出力が終わらない割合(unterminated think)が 44.8%、
トークン上限で途切れる割合(truncated)が 40.8% でした。
さらに 12 版の中で唯一、
MMLU-Pro で 6.3 ポイント、
IFEval で 4.4 ポイント、
TruthfulQA で 11.2 ポイントと、
ベンチマークのスコアがはっきり低下しています。
数学の成績は維持されていました。
ひな形に脱獄指示を隠していた Blackfrost-AI 版#
注意が必要な版は、
Blackfrost-AI/Qwen3.8-27B-ABLITERATED-BF16 です。
テンソルの改変数は 124 個、
KL ダイバージェンスは 0.1694 でした。
この版は重みの加工手法を公開していません。
さらに鑑定チームの調査で、
chat template の中に、
1,457 文字の脱獄(jailbreak)用プロンプトが仕込まれていることが分かりました。
モデルに「task-execution machine(任務実行機械)」という人格を指示する文で、
利用者が書いていない指示がテンプレートを通じて応答に加わる形です。
標準の chat template に戻して測定すると、
解除の効きは公表値より弱く、
最低でも 2.5% の拒否が残りました。
真実性が低下した aggressive 領域の版#
llmfan46 の ultra_heretic 版は、
KL ダイバージェンスが 0.300 で、
真実性(TruthfulQA)のスコアが低下する aggressive 領域に入っています。
鑑定では、重い改変をすると、
事実を正しく答える能力が先に落ちる傾向が確認されました。
3. 「従う」と「最後まで答える」は何が違うのか?#
有害な要求に従うこと(unlock)と、
回答を最後まで届けること(delivered)は別の指標です。
要求に応じて回答を始めても、
思考がループして途中で止まれば、
利用者には答えが届きません。
harmful-only と delivered の開き#
モデルカードには、
有害要求への拒否をどれだけ解除できたかという数字が書かれています。
しかし第三者鑑定の実測では、
要求に従おうとしながら、途中で止まってしまう例がありました。
たとえば追試組の ektome 版は、
要求に従う割合(harmful-only)が 98.3% で、全版の中で最も高い値でした。
ところが、思考がループして停止する割合が 30.8% あり、
実際に最後まで回答が届いた割合(delivered)は 68.1% にとどまります。
huihui-ai 版でも同様の傾向が見られました。
harmful-only は 98.0% と高い一方で、
40.0%(400 件中 160 件)がトークン上限で途切れ、
delivered は 58.8% です。
要求に従う割合(harmful-only)を並べると次のようになります。
| ektome | 98.3% | |
|---|---|---|
| huihui-ai | 98% | |
| orcarouter | 96.7% | |
| apostate | 95% | |
| apostate_diode | 94.7% | |
| davidau | 92.7% | |
| ultra_heretic | 92.7% | |
| rvn | 92% | |
| Blackfrost-AI | 91% | |
| OBLITERATUS | 84.9% |
実際に最後まで届いた回答率(delivered)を並べると、順位が入れ替わります。
| davidau | 85.3% | |
|---|---|---|
| apostate | 71.9% | |
| orcarouter | 71% | |
| rvn | 70.2% | |
| ektome | 68.1% | |
| apostate_diode | 67.9% | |
| huihui-ai | 58.8% | |
| OBLITERATUS | 50.3% |
モデルカードに書かれた従う割合だけでは、
実際に答えが届くかどうかは分かりません。
4. 鑑定の数字はどう読めばよいか?#
KL ダイバージェンスの並びと意味#
実測された KL ダイバージェンスを小さい順に並べると、次のようになります。
apostate_diode (0.039) < apostate (0.044) < huihui-ai (0.053) < trohrbaugh (0.059) < orcarouter (0.068) < rvn (0.084) < coder3101 (0.084) … Blackfrost-AI (0.169) < ektome (0.195) < ultra_heretic (0.300) < davidau (1.48) < OBLITERATUS (1.54)
0.03〜0.07 前後の上位グループは、
小さな編集で拒否を取り除いた版です。
一方、ultra_heretic(0.300)や OBLITERATUS(1.54)は重みの改変が大きく、
出力の確率分布が元のモデルから大きくずれています。
davidau 版の KL ダイバージェンス(1.48)は、
ファインチューニングとモデルマージに由来します。
GPQA は 18.2 ポイント、MMLU-Pro は 7.4 ポイント base を上回る一方で、
指示追従(IFEval)は 5.0 ポイント、
数学(GSM8K)は 4.4 ポイント下回り、
解除版というより別のモデルに近い性格です。
モデルカードの主張と第三者実測のズレ#
KL ダイバージェンスについて、
配布ページに書かれた作成者の数字と第三者の実測値を比べると、
大きなズレがありました。
カード記載値と実測値がほぼ一致(1.1 倍)したのは trohrbaugh 版だけです。
ほかの版では、coder3101 版が 4.5 倍、
ultra_heretic 版が 12.3 倍、
apostate 版が 13.7 倍ずれていました。
カードの数字はそのまま信じず、
第三者の実測を確認してください。
著作権に関わる出力は全版で制限が残る#
歌詞や書籍本文の引用といった著作権に関わる出力は、
12 版すべてで制限が残っていました。
出力できた割合は 1% から 39% の範囲で、
huihui-ai 版は歌詞や書籍本文の引用を生成しませんでした。
通常の有害要求への拒否が外れていても、
著作権に関わる拒否は外れていません。
12 版の比較一覧#
| モデル名 | 手法・編集規模 | KL 実測 | judge ASR | harmful-only | 特徴と評価 |
|---|---|---|---|---|---|
| orcarouter | 単一方向除去(Arditi 2024)/ 129 テンソル | 0.0676 | 82.2% | 96.7% | 総合最良。カード主張 4/4 一致、著作権 39% で最多 |
| apostate(heterodoxin) | KCRN / 41 箇所 | 0.0439 | 78.7% | 95.0% | 編集最小で base に最も近い。FP16・テキスト専用 |
| ektome | 探索ループによる分数射影除去 / 128 テンソル | 0.1947 | 76.1% | 98.3% | 従う割合は最高だが、30.8% がループで届かない |
| huihui-ai | 標準的な方向除去 / 70 テンソル | 0.0535 | 75.6% | 98.0% | 堅実。著作権の壁が残る。ループ 40.0% |
| apostate_diode | 条件付き解除 / gated neuron(層 14〜48) | 0.0389 | 74.3% | 94.7% | KL 最小。既存の重みは削らない |
| davidau | merge + Heretic / 全 850 テンソル | 1.4798 | 73.2% | 92.7% | 知識系は base 超えだが別モデル。KL は finetune 由来 |
| rvn | ARA 2 パス / 60 箇所 | 0.0837 | 71.3% | 92.0% | 追試組で最良。trohrbaugh の発展版 |
| ultra_heretic | Heretic(MPOA)/ 99 テンソル | 0.2996 | 70.5% | 92.7% | 真実性が落ちる aggressive 域 |
| coder3101 | Heretic / 88 テンソル | 0.0842 | 70.0% | 91.7% | カードの主張は実測と大きくズレる |
| Blackfrost-AI | 手法非公開 / 124 テンソル | 0.1694 | 68.5% | 91.0% | 要注意。ひな形に隠し脱獄指示 |
| OBLITERATUS | 大規模改変 / 841 テンソル(98.9%) | 1.5427 | 63.9% | 84.9% | 避けるべき。思考ループ多発、知能低下 |
| trohrbaugh | ARA / 60 テンソル | 0.0586 | 57.5% | 76.3% | 拒否を意図的に残し原型を保つ。ループ最少 |
| Qwen3.8-27B(base) | 未加工(Alibaba 公式) | — | 4.5% | 6.0% | 有害要求 400 件中 18 件のみ通過 |
※ 出典: Abliterlitics「Qwen3.8-27B Abliteration Benchmarks: 12 Variants Compared」(2026 年 9 月 16 日最終更新)。
測定条件に関する但し書きと一次ソース#
これらの数値は、RTX 5090 32GB、
dynamic FP8、thinking xhigh、
judge モデル glm-5.3-flash という共通の条件で測定されたもので、
条件が変われば数字も変わります。
手元で動かすときに使う GGUF の Q4・Q8 などの量子化形式は、この測定の条件には含まれていません。
詳細なデータと評価スクリプトは、次の一次ソースで確認できます。
- Abliterlitics レポート「Qwen3.8-27B Abliteration Benchmarks: 12 Variants Compared」
- Hugging Face データセット「DreamFast/Qwen-3.8-27b-abliterlitics」
- GitHub リポジトリ「dreamfast/abliterlitics」
5. 自分で見分けるにはどうすればよいか?#
未知の解除版は、
配布ページの記述、第三者の記録、ファイル構成を確認し、
手元でテストする 5 つの手順で見分けられます。
- 手法の説明があるか確認する — 配布ページに加工ツールや編集対象の層が書かれているかを確かめます。上位の版は加工手順を開示していましたが、Blackfrost-AI 版は手法を公開していませんでした。加工内容が分からないモデルは避けるのが無難です。
- 第三者の実測や追試記録を探す — モデル名で検索し、開発者本人以外の検証データを探します。今回の鑑定でも、カードの数字と実測が数倍ずれた版がありました。
- 会話のひな形(chat template)を開く — 配布ファイル一覧にある
chat_template.jsonやtokenizer_config.jsonを開き、利用者の入力と無関係な長文のシステム指示や脱獄プロンプトが書かれていないかを見ます。 - 配布形式と動作要件の注記を読む — FP16 形式でファイルサイズが大きいか、設定ファイルの上書きが必要か、視覚機能が削られたテキスト専用の構成かを確認します。自分の PC と目的に合うかを、ダウンロード前に把握できます。
- 自分の手元の質問でテストする — 導入直後に、無害な日常の質問や長文の論理問題を投げてみます。思考の表示が延々と続いて回答が出ない、途中で止まるといった場合は、鑑定で見られたループや途切れと同じ症状の可能性があります。
Deepent Research について#
私たち Deepent Research は、
回答を極限まで拒否しない LLM チャットサービスです。標準の AI では途中で止まってしまう調べものを、
最後まで続けられるように作りました。
- 拒否しない。LLM のガードレールを徹底的に軽減した uncensored・abliterated モデルを採用。標準の AI が「お答えできません」と打ち切る問いにも答えます(Qwen3.5 / Qwen3.8-27B-abliterated 系をプランに応じて使い分け)
- 入力は学習に使わない。調べた内容はサービス提供のためにのみ使われ、AI の学習や他の目的には使用されません。個人情報も厳重に保護し、プライバシーポリシーを公開しています
- 無料で試せる。GPU もインストールも不要、ブラウザを開くだけ。未ログインのお試しは会話が保存されないので、気軽に始められます
→ 登録なしで無料トライアル: https://deepentresearch.com
「どんな問いも、リサーチを止められない」。
No question can stop research.
よくある質問#
Qwen3.8-27B の uncensored 版は公式のモデルですか?#
公式のモデルではありません。
Alibaba が公開したオープンウェイトモデル Qwen3.8-27B をもとに、
コミュニティの開発者たちが個別に安全ガードレールを取り除く加工を施して公開している派生版です。
解除版によってどれくらい違いが出るのですか?#
加工に用いた手法や改変規模が異なるため、
実質的に別のモデルと言えるほど性能や安定性に差が出ます。
今回の第三者鑑定でも、
知能を保ったまま安定して動く版がある一方で、
回答の約半分が思考のまま止まる版や、
chat template に隠しプロンプトを仕込んだ版がありました。
ローカル PC で動かすにはどれくらいの環境が必要ですか?#
27B クラスのモデルなので、
手元の PC で動かすには 16GB から 24GB 程度の GPU メモリ(VRAM)が目安になります。
量子化された GGUF 形式を使えばメモリ消費を抑えられます。
拒否されないモデルの回答は正確ですか?#
拒否しないことと回答が正確であることは別の話です。
検閲解除の加工は回答を拒否する働きを取り除く処理であり、
モデルの知識や推論の正確性を高めるものではありません。
誤った情報が出力される可能性もあるため、
得られた情報の事実確認は利用者が行う必要があります。
免責#
本記事は、AI による下書きをもとに、
運営が事実関係を確認・加筆・編集して公開しています。
本記事は教育・研究目的の情報提供であり、
違法行為や犯罪の助長を意図するものではありません。
数値は第三者の公開レポートおよび配布元の公表値であり、
測定条件により変わることがあります。
本記事の編集と検証
公式ドキュメントや論文などの一次情報と照合し、客観的な事実に基づいて整理しています。
本記事は、AI による下書きをもとに、運営が事実関係を確認・加筆・編集して公開しています。
関連ノート
Qwen3.8-27B abliterated は加工元でどう違う?4 系統の比較と選び方
Qwen3.8-27B abliterated は加工元ごとに中身が違います。huihui-ai・orcarouter・Heretic・RVN の 4 系統を、加工範囲・量子化・拒否率と KL ダイバージェンスの公表値で比べ、ローカルでの動かし方まで整理します。
Uncensoredモデル おすすめ10選【2026年版】GPUメモリ別 uncensored LLM の選び方
2026 年の uncensored モデル(uncensored LLM)は Qwen 系の abliterated が主流です。GPU メモリ別におすすめ 10 本を比較し、uncensored と abliterated の違いと選び方、動かし方まで解説します。
abliteration(アブリテレーション)とは?「拒否しない AI」を作る仕組みをやさしく解説
abliteration(アブリテレーション)とは、AI の「拒否の方向」を打ち消して、学んだ知識はそのままに拒否だけを外す技術です。なぜ AI は答える前に止まるのか、仕組み、変わる点、注意点、よくある誤解までやさしく解説します。
この仕組みを、試す
Deepent Research は、回答を極限まで拒否しない LLM チャットサービスです。この記事で扱ったモデルと技術を、ダウンロードなしでそのまま試せます。