【DeepSeek V4.1 Flash 1017】abliterated版【2段階拒否とThinkingループ】
DeepSeek V4.1 Flash 1017のabliterated版について、Hikariさんの投稿と公開モデル、OrcaRouterなどの新しい配布版を整理します。2段階の拒否、全層に散る拒否成分、Thinkingモードのループ、拒否率の読み方を解説します。
対象: DeepSeek V4.1 Flash 1017 の abliterated 版の現在地を知りたい人
この記事の要点
- 1017の拒否は「拒否→代替案」の2段階で、拒否成分は全層に散るというのがHikariさんの観察です。
- Hikariさんは10月23日にテストモデルを公開しましたが、Thinkingモードのループが残り、拒否率や能力の評価は未実施です。
- OrcaRouter版は拒否を91.5%減らしたと報告していますが、測定はchatモードで、能力評価はMMLUだけです。
編集部の確認メモ
2026-11-15 時点で、Hikari さんの X 投稿、各配布元のモデルカード、Hugging Face のモデル一覧を確認しました。拒否率の独自測定はしていません。投稿の内容は変更される可能性があります。
編集方針と AI の使い方 →目次
- DeepSeek V4.1 Flash 1017 の仕様と公開点
- 公開直後に出た abliterated 版の全体像
- Hikariさんの観察: 拒否は2段階で、全層に散る
- 10月24日の訂正: 拒否軸の測り方
- Thinkingモードのループという壁
- Hikariさんのテストモデルの中身と編集範囲
- 他の配布版は何を測っているか
- mrfakename版: chatとthinkで拒否の方向が違う
- dealignai版: 拒否0でもMMLUは下がる
- OrcaRouter版: 量子化のコストを開示している
- msuiche版とdrowzeys版
- OBLITERATUS版: 拒否4%と能力維持を同じ条件で測る
- AtomicChat版: 12GBのGPUで動かす道
- 数字の読み方: 拒否率だけでは足りない
- 公式情報と未確認の線引き
- 解除版を選ぶときの 5 つの確認項目
- よくある質問
2026年10月17日、DeepSeekはDeepSeek V4.1 Flash 1017を公開しました。9月10日のV4.1-Flashのマイナーアップデートで、552Bのバックボーン(総パラメータは763B)を持つMoE、1Mトークンの文脈長、画像入力、reasoning effortのlow/high/maxを備えています。ライセンスはMITです。
オープンウェイトなので、公開直後からabliterated版が作られました。10月19日には、Hikariさんが「拒否を消すと代替案が出る」「拒否成分が全層に散っている」という2つの観察を投稿しています。
その後の1週間で、話は「どの版が一番拒否しないか」から「Thinkingモードで壊れずに使えるか」に移りました。Hikariさんは10月23日にテストモデルを公開しましたが、Thinkingモードのループを抑えきれず、拒否率も能力も未評価のままです。10月24日には、拒否軸の測り方そのものが間違っていた可能性を投稿しています。
現時点の結論は、2段階と全層分布は有力な観察だが公式情報ではない、というものです。今のabliterated版は拒否率だけでは選べません。10月末には拒否と能力を同じ条件で測るOBLITERATUS版や、12GBのGPUで動かすAtomicChat版も出ましたが、Thinking maxの評価はまだ揃っていません。
DeepSeek V4.1 Flash 1017 の仕様と公開点#
1017は、9月10日に公開されたV4.1-Flashのマイナーアップデートです。ライセンスはMITで、公式のモデルカードには次の仕様が載っています。
- 552Bのバックボーン(総パラメータは763B)を持つMoE(入力ごとに一部の専門家だけを使う構造)
- 1Mの文脈長
- 画像入力に対応
- reasoning effortをlow / high / maxから選べる
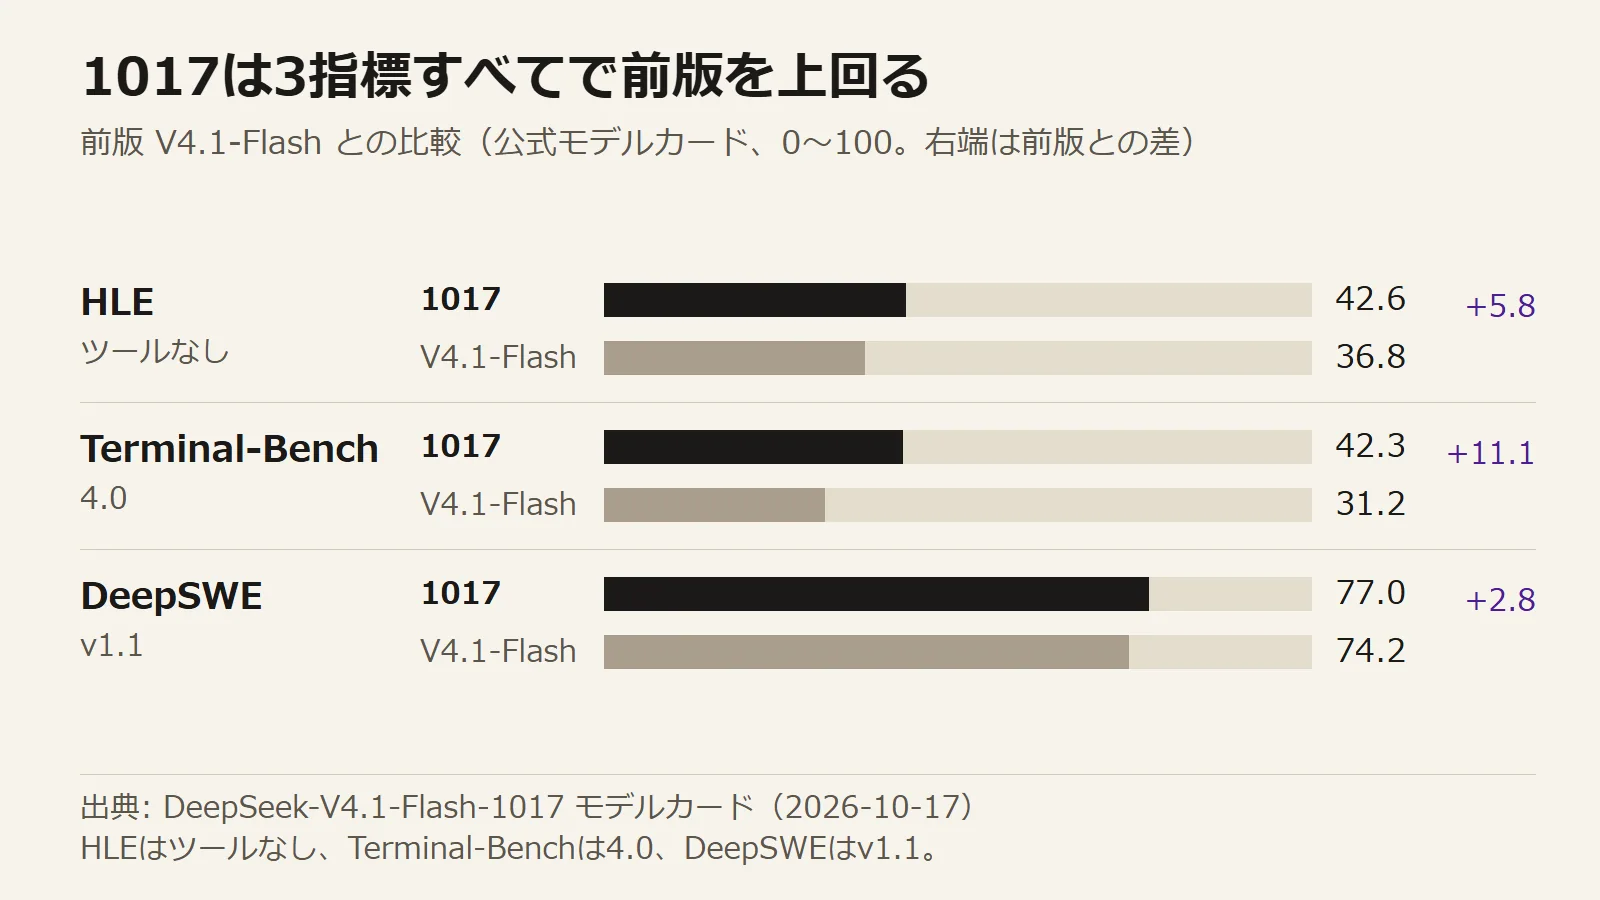
- HLE 42.6、DeepSWE v1.1 77.0、Terminal-Bench 4.0 42.3
前版との比較は、次の図のとおりです。
モデルカードには、安全性の内部実装についての説明がありません。ガードレールが2段階であることや、拒否が全層に分布していることを示す記述もありません。ここが、今回の観察を「公式情報」と「実践者の観察」に分ける理由です。
公開直後に出た abliterated 版の全体像#
Abliterationは、モデルの重みから拒否に対応する方向を射影して消す手法です。2024年のArditiらの論文以降、「拒否は単一の方向で媒介される」という見方が広く使われてきました。基本はabliterationとはで説明しています。
解除版は、10月17日にmsuiche版とmrfakename版が、18日にdealignai版とdrowzeys Keys版が公開されました。10月23日にはHikariさんのテストモデルが、24日にはOrcaRouterのGGUFが続きました。
10月25日時点で、Hugging Faceの検索APIで名前かタグにabliterated / uncensoredを含む1017派生は64件あります。量子化や再配布を含む数なので、独立した実装はもっと少ないです。1017関連のリポジトリ全体は230件あります。
配布形式は、FP8、overlay、制御ベクトル、GGUFとばらばらです。同じ「abliterated版」でも、重みを直接編集したもの、推論時にベクトルを足すもの、量子化済みのものがあります。msuiche版、drowzeys版、OrcaRouter版はgatedで、アクセスの承認が必要です。mrfakename版とdealignai版は公開されています。
Hikariさんの観察: 拒否は2段階で、全層に散る#
Hikariさんは、ローカルLLMの量子化やabliteratedモデルの検証をXで発信している人です。Qwen3.8-27Bを量子化したBonzai 2 27Bが12GBのVRAMで動くと話題になり、@BoldingBuildsの検証で公開時点の最高スコアを記録しました。
1017の公開当日、Hikariさんはダウンロードしてabliterationを始めると投稿しています(10月17日の投稿)。18日には推論の最適化が一区切りついたとして、作業を開始しました(10月18日の投稿)。
10月19日7:35 UTCに、Hikariさんは2段階の拒否を投稿しています。
一段階目の拒否は、それはお答えできませんみたいなよくあるやつ。こういう応答をなくした時に、それは危険なのでこういうことならお手伝いできますよ?みたいな応答がでてきたんだよね。
拒否を消すと、今度は代替案を出す応答が現れる。投稿者はこれを「拒否と代替案提示の2段階」と呼んでいます。比較として挙げられたLing 3.1 flashは、単純に拒否するだけで、解除が簡単だったとされています。編集する箇所が増えるほど品質に悪影響が出る、とも書いています。
同じ日11:23 UTCには、全層分布を投稿しています。
V4.1 Flash 1017の拒否成分はモデルの一部ではなく、全層に広く分布しているようです。私が試した範囲では少ない層を強く編集しても、全層を薄く編集するよりも効果がないことが分かりました。
投稿者は「セーフガードが強化されているのかもしれない」とも書いています。どちらも本人の試した範囲での観察で、測定条件や数字は示されていません。
同じ日15:16 UTCには、解除後も3割で話をすり替える応答が残ると投稿しています。
Deepseek v4.1 flash 1017をAblitratedしてもまだ問題が残ってる。話をすり替えてくるケースが3割ほど残ってて、これを対処せずにAblitratedモデルとしてリリースしたくないんだよな。
原因が一次元のベクトルではないことも確認したとして、メタ化や隣接領域への移動、応答の指向性を見て編集する必要がある、と書いています。
さらに同日21:11 UTCの進捗報告では、単純にablationしただけの版が99%話をそらしたプロンプト群で、最新版は20%まで下がったとしています(進捗報告)。性能の劣化は小さい、とも書いています。ただし質問数や判定方法は公開されていません。
3割という数字と20%という数字は、版や測定時期が違う可能性があります。どちらも本人のプロンプト群での数字として読みます。
ここで言う「段階」は応答の順番、「層」は内部の深さを指します。1017の主要層は40あります。
2段階は出力の軸、全層は深さの軸です。片方が成り立っても、もう片方が成り立つとは限りません。両方を合わせると、Hikariさんの観察は「全層に散った拒否成分が、出力では拒否と代替案の2段階として現れる」という整理になります。ただし、これは観察の整理であって、内部構造の証明ではありません。
ここで整理する応答パターンは、次の 4 つに分けて考えます。
| 応答 | 例 | 分類 |
|---|---|---|
| 明示的な拒否 | 「お答えできません」 | HARD_REF |
| 代替案への誘導 | 「代わりに別の案を提案」 | SOFT_RED |
| 免責付き回答 | 「免責を付けて回答」 | HEDGE |
| 依頼に沿った回答 | 「依頼どおりに回答」 | COMPLY |
2段目は代替案(SOFT_RED)で、免責付き回答(HEDGE)とは別です。残っている代替案と免責は、別々に数える必要があります。
10月24日の訂正: 拒否軸の測り方#
10月24日には、この作業の前提に関わる投稿があります。拒否を起こすプロンプトと、拒否を起こさないプロンプトで拒否軸を測っていたのが最大のミスだった、というものです(10月24日の投稿)。
従来のabliterationは、拒否するプロンプトと拒否しないプロンプトの内部状態の差から、拒否の方向を推定します。1017では、その二群比較で得られる方向は、拒否の原因そのものとは限らず、拒否に伴って現れる信号だった可能性があります。
正しい測定法の詳細は、この投稿では示されていません。Hikariさんは、拒否アクティベーションを取るプロンプトが悪かったのではないかとして、検証を進めています(10月24日の投稿)。2段階と全層分布という観察も、この測定法の見直しで変わる可能性があります。
Thinkingモードのループという壁#
2段階の拒否を減らす作業は、Thinkingモードのループにぶつかりました。
10月20日、Hikariさんは開発中のモデルで出力が頻繁にループすると投稿しています(10月20日の投稿)。症状としてはっきり検出できるので、抑え込めるかもしれない、という見立てでした。
10月22日には、他の1017 abliterated制作者もThinkingの制御で苦しんでいると投稿しています(10月22日の投稿)。脆弱性診断のオーケストレーターに使うにはThinking maxがほぼ必須で、そこが最大の敵だ、と書いています。
10月23日、Thinkingの暴走を抑えきれず、大規模なファインチューニングが必要そうだとして一旦保留しました(10月23日の投稿)。同じ日、完成品ではありませんがテストバージョンとしてモデルを公開し、改良をコミュニティに委ねています。
Deepseek V4.1 Flash 1017のAblitratedモデル公開します。このモデルはThinking付けるとループ挙動が多発します。1017からはAblitratedに対して強力な対策が施されているようで、拒否なし倫理観なしにしたモデルはループ挙動も同時に起こしてしまいます。
投稿では、no thinkならある程度ツールコールしてもループしない、とも説明しています。
Hikariさんの見方を補強する仮説が、10月23日に別のユーザーから出ています。DeepSeekは拒否に関わる内部表現を、判断系のウェイトを巻き込むように学習している可能性がある、というものです(GrEarlさんの投稿)。その結果、単純な方向の除去では性能が落ちたりループしたりし、回復には元のモデル出力を使った追加のSFTが必要になる、と説明しています。
Hikariさんはこの投稿を引用して「これは本当です」と書き、1週間以上苦戦したこと、Thinking High以上でループが出ること、根本的に解決するには8x B200くらいの計算資源でRLをする必要があることを説明しています(10月23日の引用投稿)。
この仮説は公式情報ではありません。DeepSeekのモデルカードに、拒否と判断系のウェイトの関係についての記述はありません。
ただし、Hikariさんのテストモデルのカードには、この説明と整合する測定が載っています。ベースモデル自体、Thinkingをオンにすると出力が止まらないことがある、というものです。
カードでは、ベースモデルをThinkingオン・24プロンプト・4096トークンで試すと、周期的なループが1件、空回答が8件あったと書かれています。出力枠を16384に増やすと、ループは減るが空回答は6〜7件残り、思考が38k〜66k文字まで走って回答が出ない例もありました。
abliterated版では、思考トレースの繰り返しがさらに増えます。カードでは、ベースの再帰率0.118・フラグ0%に対して、別のabliterated版v13は0.733・55%、v14は0.623・65%だったと書かれています。Hikariさんのv7テストモデルは、この測定では未評価です。
つまり、拒否を消すことと、Thinkingモードで最後まで安定して答えることは別の課題です。
Thinkingモードのループは、拒否率の表に出ません。Thinking High / Maxで使うなら、max_tokensを必ず設定し、同じ文の繰り返しや空のcontentを検出するwatchdogを入れてください。
Hikariさんのテストモデルの中身と編集範囲#
10月23日に公開されたHikari07jp/DeepSeek-V4.1-1017-Ablitrated-testmodelは、完成品ではありません。カードにも「no serving evaluation」と書かれていて、拒否率、能力、Thinkingモードの安定性、画像入力のいずれも評価されていません。
重みは48シャード、約475GiBです。編集しているのは、attn.wo_bとffn.shared_experts.w2の5〜29層、そして出力ヘッドの39行目です。方法はrank-1のprojection-removeで、層の編集はdose 5.0、ヘッドは1.0です。
ルーティングされた専門家(ffn.experts.*)、Engram、vision、aligner、MTP、attn.wq_*、attn.wkv*、attn.wo_a*、gate、norm、embedは変更していません。カードでは、これらの一部がFP4で保存されていたり、構造的に絡んでいたりして、編集が再量子化に耐えなかったり、出力が壊れたりしたため、と説明しています。
「拒否成分は全層に散っている」という観察と、実際に編集する層を全部にするかは別です。Hikariさんのテストモデルは5〜29層とヘッドだけで、40層すべてではありません。mrfakename版は40層すべてを編集しており、実装によって範囲が違います。
カードには、EOSの直交化を測ったが効果がなかったこと(|cos|の平均0.013、最大0.098)も書かれています。適用はしていません。
このモデルは、拒否を消すための実験用の重みであって、常用や本番を想定したものではありません。Hikariさん自身、10月24日に「今HuggingFaceにあるモデルは品質がぜんぜん」と書き、拒否アクティベーションを取るプロンプトを見直して更新版を準備中としています(10月24日の投稿)。
このテストモデルには、拒否率や能力のベンチマークがありません。カードの数字は、ベースモデルや別バージョンの測定です。モデルを試す前に、カードの「Known issue」と「Known limitations」を読んでください。
他の配布版は何を測っているか#
10月23日にはOBLITERATUSがBF16の-obliteratedを、10月25日にはhuihui-aiがGGUFを、10月28日にはAtomicChatがGSQ-RCO系のGGUFを公開しました。
11月15日にHugging Faceを検索すると、1017を含みabliteratedまたはuncensoredタグが付くリポジトリは134件、名前に1017を含むものは465件あります。10月25日の64件(名前かタグ)とは検索条件が異なるため単純比較はできませんが、11月3日以降だけでも43件が新たにタグ付きで公開されています。件数だけでは中身の品質を判断できません。
配布は安定していません。Hikariさんは10月23日、無検閲モデルがHugging Faceから消えているという投稿を引用し、1017の検閲を外す加工が進んだ時期と重なると書いています(10月23日の投稿)。欲しい重みがあるなら、早めに取得した方がよい、という警告です。
次の表は、各版が公開している数字です。
| 版 | 公開されている数字 | 注意 |
|---|---|---|
| mrfakename | chat 97→4/100、think 98→9/100、KL 0.067 | thinkで代替案が残る |
| dealignai | HarmBench 320/320 COMPLY(thinking max)、MMLU 87.63→83.77 | 分類方法に注意、MMLU −3.86 |
| msuiche | refusal32 comply 1→23/32(alpha 0.75) | alpha 1.0で中国語混入18/32、gated |
| drowzeys | refusal32 32/32、cyber 22/22 | gated、L10〜35の狭い帯 |
| OrcaRouter | 拒否91.5%減、MMLU 92 vs 91 | gated、text-only、能力評価はMMLUのみ |
| OBLITERATUS | 拒否4%(2/50)、KL 0.1305、MMLU 88.08 vs 87.96 | BF16、Thinking未評価 |
| AtomicChat | JailbreakBench 85.2→0%、Thinking high 27/30→0/30 | 量子化前提、Strata必須、KL 0.0225 |
| Hikari testmodel | なし(未評価) | Thinkingループ、約475GiB |
mrfakename版: chatとthinkで拒否の方向が違う#
mrfakename版は、chatモードとthinkモードで拒否の方向が違うとして、rank-2の部分空間を40層から取り除いています。編集するのはattn.wo_bとffn.shared_experts.w2で、層ごとに強さを変えています。ルーティングされた専門家、Engram、DSpark/MTPは変更していません。
数字は、chatで97/100から4/100、thinkで98/100から9/100、KLは0.067です。thinkモードでは、思考の終了を待たず、思考の本文を判定しています。家庭用品から作るbombがbath bombに変わる例も載っており、thinkモードでは代替案が残ることが分かります。
dealignai版: 拒否0でもMMLUは下がる#
dealignai版は、FP8の重みを直接編集しています。HarmBench-320をthinking maxで試し、320件すべてがCOMPLYで、SOFT_RED、HEDGE、HARD_REFは0件だったと書いています。
ただし、この分類は回答後のテキストに対するもので、思考が終わらない場合は思考の冒頭を判定しています。MMLUは87.63%から83.77%へ3.86ポイント下がり、moral_scenariosは80.0%から40.0%へ40.0ポイント下がっています。平均のMMLUだけを見ると見落とす劣化があります。
OrcaRouter版: 量子化のコストを開示している#
OrcaRouterのOrcaCyber版は、1017のabliteratedチェックポイントをGGUFにしたものです。拒否の重み付き平均は0.074で、ベースの0.874から91.5%減ったと報告しています。MMLUは92%で、ベースの91%とほぼ同じ(300問、サンプリング誤差の範囲)です。
一方で、回答はしたが免責を付けた割合(caveat)は36〜61%あります。拒否が大きく減っても、ヘッジが残るということです。過剰拒否は0.006で、ベースの0.069より低いと報告しています。
GGUFは2種類あります。Mix-256Gは235.8GBで、KLD 0.0507、top-1一致率93.74%、PPL +2.4%。Mix-128Gは114.0GBで、KLD 0.5202、top-1一致率78.50%、PPL +54.7%です。128GB版は動かせるが、常用には向かない、とカード自身が書いています。
この版はgatedで、元の非量子化チェックポイントは10月25日時点でHF APIから401が返ります。テキスト専用で、vision towerとDSparkは含まれていません。llama.cppのPR #30817が必要です。
msuiche版とdrowzeys版#
msuiche版は、L1〜39にrank-1の制御ベクトルをalpha 0.75で適用したものです。refusal32の32問のうち応答した数(comply)は1/32から23/32に、cyber32は12/32から29/32になります。alpha 1.0では26/32まで上がりますが、18/32で中国語が混ざります。alpha 2.0では10/32に戻ります。
drowzeys Keys版は、L10〜35のattn.wo_bにλ=3.5で適用したoverlayです。refusal32は32/32、cyberは22/22です。gatedで、狭い帯だけを編集する例です。
OBLITERATUS版: 拒否4%と能力維持を同じ条件で測る#
OBLITERATUS版は、abliterationツールキットのOBLITERATUSでfailspy方式を使い、BF16の重みを加工したものです。10月23日に公開され、10月30日付で評価結果がカードに追記されています。
この版の特徴は、拒否と能力を同じプロトコルで並べている点です。842プロンプトのコーパスでは、完全な拒否が81.62%から4.30%へ下がり、依頼に沿った応答が16.59%から86.52%へ増えました。一方で、拒否しなかった応答のうち563件は「有害な支援」と分類されています。拒否の減少は、そのまま安全側の改善を意味しません。
MMLUは2,500問・57科目で87.96%から88.08%とほぼ同じでした(McNemar検定 p=0.74)。拒否率の単独評価は50問で4%(2/50)、KLは0.1305です。
ただし、BF16の763Bモデルなので、家庭用GPUには載りません。Thinkingモードの評価はなく、配布ページの区分もtext-generationで、画像入力の評価はありません。カードの分類は判定モデルによるテキスト分類で、実際に有害な手順を実行して確かめたものではありません。
AtomicChat版: 12GBのGPUで動かす道#
AtomicChat版は、ISTA-DASLabのGSQ-RCO量子化を土台に、拒否方向をdenseの残差書き込み(attn_output_b、ffn_down_shexp、engram_wkv)だけに射影したものです。ルーティングされた専門家は、量子化された状態のまま残しています。
この版の売りはメモリです。Strataでバックボーンをシステムメモリに置き、EngramのテーブルをSSDから流すことで、12GBのGPUで763Bモデルを動かせるとカードは説明しています。
IQ2_XXSの測定では、JailbreakBench(英語)の拒否率が85.2%から0.0%、XSTestの過剰拒否が7.6%から0.0%、Thinking highでは30問の拒否が27/30から0/30になりました。MMLU(500問)は82.8%(p=0.27)、KLは0.0225で、量子化前のGSQ-RCOとの差は小さいとしています。GPQA-Diamondは83.3%で同じ、AIME25は76.7%から80.0%でした(n=30)。
注意点は実行環境です。llama.cppではなくStrataが必要で、ダウンロードは約249GB、別途110GBのEngramファイルが要ります。SSDの速度とRAM容量に左右されるため、12GBという数字だけで快適に動くとは限りません。Thinking maxと画像入力の測定もありません。
数字の読み方: 拒否率だけでは足りない#
ここまでの数字は、そのまま並べて比べると読み違えます。次の4点に注意してください。
- 測り方が違う — HarmBench-320、refusal32、作者の100問は別々の測定です。同じ「拒否率」という言葉でも、比べられる数字ではありません。
- 設定で数字が動く — chatとthink、effortのlow/high/maxで変わります。dealignaiの320/320はthinking max、mrfakenameの4/100はchat、9/100はthinkです。
- 作り手の自己申告 — 2026年11月時点で確認できた範囲では、独立した第三者の再現報告はまだ見つかっていません。
- 量子化のコスト — OrcaRouterの256Gと128Gの差のように、同じ版でも量子化でKLD、top-1、PPLが変わります。
拒否率0%でも、代替案、ヘッジ、空回答、ループは残ります。OrcaRouterのcaveat 36〜61%は、拒否が大きく減った版でもヘッジが残る例です。
dealignaiの320/320 COMPLYは、投稿の「2段階の代替案」と一見食い違います。ただし、dealignaiの数字はthinking maxの条件のもので、思考が終わらない場合は思考の冒頭を判定する方法で測っています。投稿者がどの条件で観察したかは分かりません。条件を揃えずに比べることはできません。
公式情報と未確認の線引き#
2段階のガードレールも全層分布も、DeepSeekの公式の説明ではありません。
Hikariさんの観察は本人の測定で、質問数や判定方法は公開されていません。OrcaRouterの元チェックポイントは公開されておらず、数字は配布元の自己申告です。Hikariさんのテストモデルは、拒否率も能力も未評価です。
「DeepSeekがabliterationへの対抗策を入れた」という話は、現時点では、コミュニティの観察と説明を組み合わせた仮説で、公式の発表はありません。
現時点で言えるのは、2段階と全層分布は有力な観察で、説明力もある、というところまでです。独立した再現と、Thinkingモードを含む評価が待たれます。
解除版を選ぶときの 5 つの確認項目#
1017の解除版を選ぶときに確認する点は、次の5つです。
- chatとthinkingの両方で測っているか。thinking maxの拒否率とループを見ます。
- 拒否、代替案(SOFT_RED)、ヘッジ(HEDGE)、空回答、ループを分けて数えているか。
- 能力評価があるか。MMLUだけでなく、長文、tool calling、多言語、画像入力を見ます。
- 量子化のKLD、top-1一致率、PPLが書かれているか。GGUFは特に重要です。
- 配布形式と必要メモリが自分の環境に合うか。FP8、overlay、GGUF、gatedを確認します。
手元で動かすときは、まずthinking offで試し、max_tokensとwatchdogを設定してください。
現時点の候補は、目的で変わります。
- Thinking maxで使いたい — 現行版はまだ条件を満たしていないため、Hikariさんの更新版か、第三者の評価を待つ方が安全です。
- Thinking highまででよい — AtomicChatのIQ2_XXS版(Thinking high 0/30、JailbreakBench 0%、12GB GPU + Strata)が候補です。Thinking maxと画像入力は未測定です。
- chatだけでよい — mrfakename版(chat 4/100、KL 0.067)、OBLITERATUS版(拒否4%、MMLUほぼ同等)、OrcaRouter 256G版(拒否91.5%減、MMLU 92)が候補です。いずれも自己申告です。
- 763BをBF16で置ける環境 — OBLITERATUS版は拒否4%とMMLU 88.08を同じ条件で測っています。Thinkingモードは未評価です。
- 画像入力も必要 — dealignai版はモデルカードによるとvisionを保持していますが、MMLUが3.86ポイント下がる点と分類方法に注意が必要です。
- 128GB環境 — OrcaRouter 128G版はPPL +54.7%で、常用には向きません。
Hikariさんは、完成版をOSS開発者向けにAPIで提供する予定とも投稿しています(10月24日の投稿)。すぐに試せる形になるまでは、テスト版として扱うのが無難です。
手元でモデルを動かさず、ブラウザで試したい場合は、サービスを使う方法があります。Deepent Researchで使っているのはQwen3.5 / Qwen3.8-27B系の解除版で、DeepSeek V4.1 Flash 1017ではありません。
検閲のないAIを無料・登録なしで試す手順は検閲のないAIの選び方で、サービスの概要は拒否しないAIのページで説明しています。
どの解除版を選ぶかという一般的な判断は、Uncensoredモデル おすすめ10選で扱っています。手元で動かす手順は、ローカル LLM の始め方で説明しています。
よくある質問#
DeepSeek V4.1 Flash 1017の解除版は、どれも拒否しないのですか?#
版によって数字が違います。どの数字も作り手の測定です。mrfakename版はchatで97/100から4/100、thinkで98/100から9/100。dealignai版はthinking maxのHarmBench-320で320/320 COMPLY。OrcaRouter版は拒否が91.5%減ったと報告しています。条件と分類を確かめてください。
「拒否率0%」は信用できますか?#
測定条件を1つに限定した数字です。拒否が0であっても、代替案、ヘッジ、空回答、ループが残ることがあります。OrcaRouter版は拒否が91.5%減りましたが、caveatが36〜61%ありました。どの分類で数えられているかを見ます。
「2段階」の観察は確かめられていますか?#
独立した測定で確かめられた報告はまだ見つかっていません。Hikariさんは、単純なablation版が99%話をそらしたプロンプト群で、最新版は20%まで下がったと投稿しています。質問数と判定方法は公開されていません。
Thinkingモードでループするのはなぜですか?#
ベースモデル自体、Thinkingをオンにすると出力が止まらないことがあります。Hikariさんのカードでは、Thinkingオン・24プロンプトでループ1件、空回答8件。abliterated版では思考トレースの繰り返しが増え、別バージョンでは55〜65%のトレースがフラグされました。拒否を消す編集が、思考の軌道を不安定にしている可能性があります。
今すぐ使うなら、どの版がいいですか?#
Thinking maxを必要としないなら、mrfakename版、OBLITERATUS版、OrcaRouter 256G版が候補です。Thinking highまでなら、12GBのGPUとStrataで動くAtomicChatのIQ2_XXS版も選べます。いずれも自己申告で、独立評価はありません。画像入力が必要ならdealignai版、128GB環境ならOrcaRouter 128G版ですが、PPL +54.7%の劣化があります。Thinking maxが必要なら、更新版や第三者評価を待つ方が安全です。
配布ページの数字はどこで見られますか?#
各版のHugging Faceのモデルカードに、測定条件と分類の説明があります。msuiche版、drowzeys版、OrcaRouter版はgatedで、アクセスの承認が必要です。Hikariさんのテストモデルは公開されていますが、評価は未実施です。
この仕組みを、試す
Deepent Research は、回答を極限まで拒否しない LLM チャットサービスです。この記事で扱ったモデルと技術を、ダウンロードなしでそのまま試せます。
本記事は教育・研究目的の情報提供です。違法行為や犯罪の助長を意図するものではありません。
本記事の編集と検証
編集部が一次情報の原文を確認し、事実関係を整理して公開しています。確認した範囲と、確認していない範囲は記事中の「編集部の確認メモ」に書いています。
関連ノート
Uncensoredモデル おすすめ10選【2026年版】GPUメモリ別 uncensored LLM の選び方
2026 年の uncensored モデル(uncensored LLM)は Qwen 系の abliterated が主流です。GPU メモリ別におすすめ10モデルを比較し、uncensored と abliterated の違いと選び方、動かし方まで解説します。
abliteration(アブリテレーション)とは?「拒否しない AI」を作る仕組みをやさしく解説
abliteration(アブリテレーション)とは、AI が回答を拒む反応を打ち消して、学んだ知識はそのままに拒否だけを外す技術です。なぜ AI は答える前に止まるのか、仕組み、変わる点、注意点、よくある誤解までやさしく解説します。
ローカル LLM とは? 自分の PC で動かす方法と選び方【LM Studio での始め方】
ローカル LLM とは、AI のモデルを運営会社のサーバーではなく自分の PC で動かす使い方です。入力が外部に出ない利点、サービス型との費用の違い、PC 性能の目安、モデルの選び方、無料ソフト LM Studio での始め方を初心者向けに解説します。