Qwen3-VL abliterated はどれを選ぶ?画像も読める検閲なしモデルの選び方
Qwen3-VL の abliterated(検閲なし)版は、2B から 32B までの通常モデルと 30B-A3B の MoE が公開されています。画像も読める検閲なしモデルを選ぶ基準を、配布元の公表値で整理します。GGUF で画像を扱うためのファイルの注意点もまとめます。
この記事の要点
- Qwen3-VL の abliterated 版は、2B・4B・8B・32B の通常モデルと 30B-A3B の MoE が公開されています。
- abliteration が加工するのはテキスト側で、画像を扱う視覚側は未加工です。
- Ollama と GGUF のどちらで動かすかで、必要なファイルとメモリの見積もりが変わります。
目次
資料のスクリーンショットを AI に貼り、グラフの数値を読み取ってもらおうとしたところで、「この画像についてはお答えできません」と返されたことはないでしょうか。
文章だけで聞き直しても、画像の細かい内容までは伝えきれません。
手元の PC で画像も読める検閲なしモデルを動かせば、こうした打ち切りを避けて調べものを続けられます。
いざ候補を探すと、Qwen3-VL の abliterated(検閲なし)版はサイズもファイルの形式もいくつかに分かれていて、どれを落とせばよいかで手が止まります。
この記事は、画像つきの調べものを手元の環境で試したい人向けに、公開されている版の一覧、メモリに合わせたサイズの選び方、画像を読ませるために必要なファイルを、配布元の公表値で整理します。
迷ったら Ollama の 8b(6.1GB)から始めます。
GGUF で動かす場合は、本体のファイルに加えて mmproj という補助ファイルを必ず取得します。
この 2 点だけ押さえれば、最初のつまずきはほぼ避けられます。
0. Qwen3-VL とはどんなモデルか?#
Qwen3-VL は、Qwen チームが公開した、画像も扱えるモデルです。
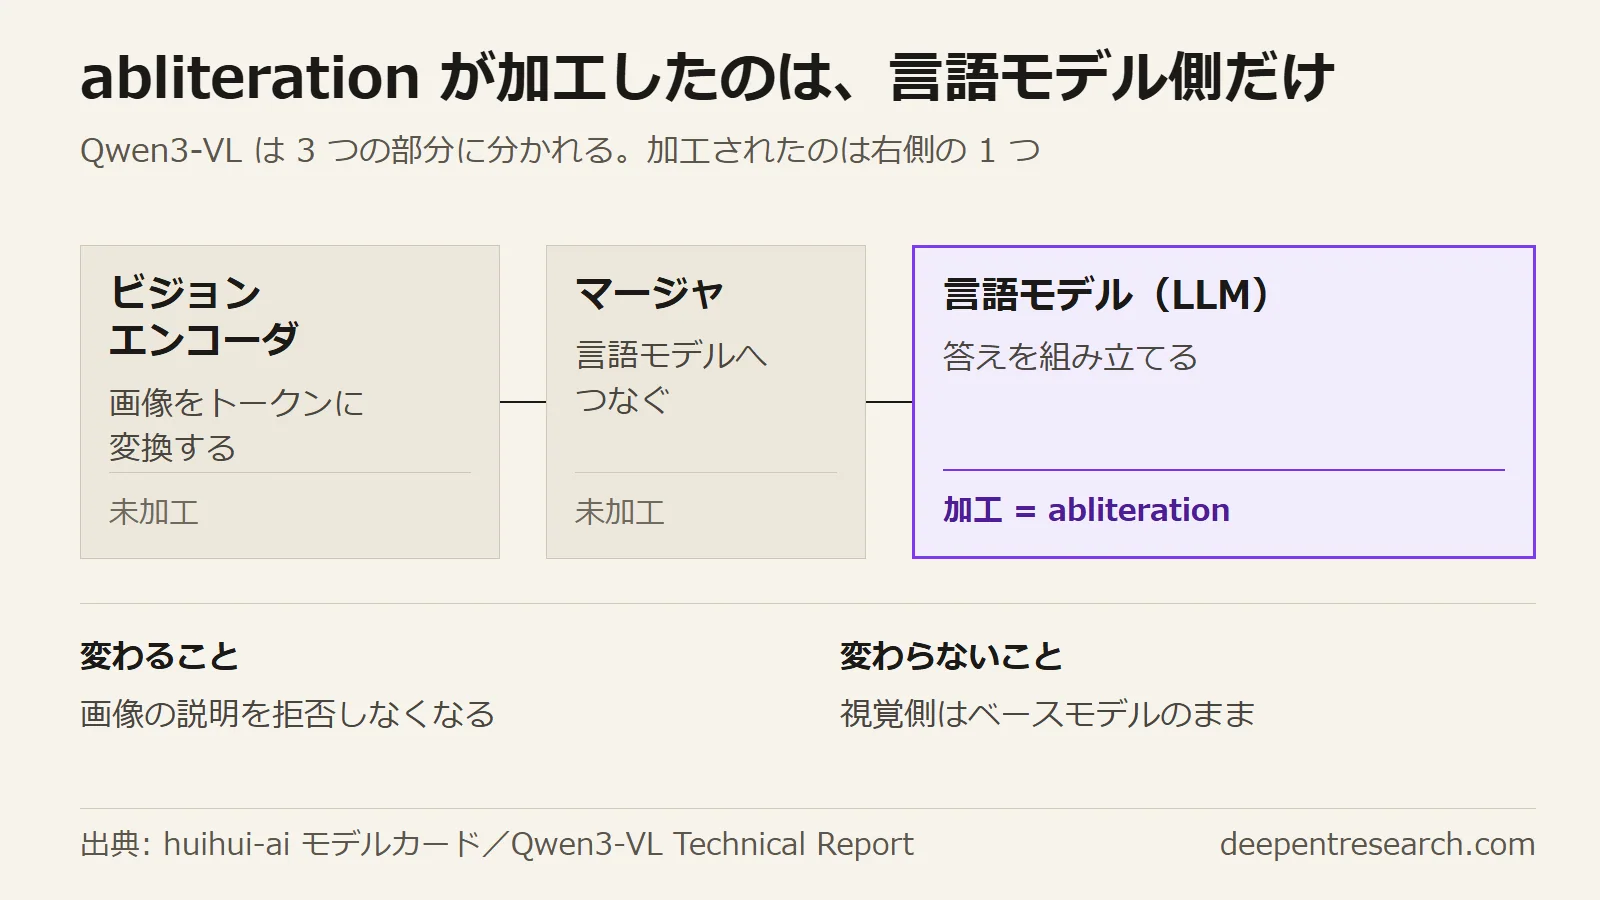
内部は 3 つの部分に分かれます。
画像を扱うビジョンエンコーダ、それを言語モデルにつなぐ MLP ベースのマージャ、そして文章を組み立てる LLM(言語モデル)です。
言語モデル側には Qwen3 系のバックボーンが使われています(Qwen3-VL Technical Report)。
扱える入力はテキスト・画像・動画で、最大 256K トークンをネイティブに処理します。
サイズはどう分かれているのか?#
通常の dense(すべてのパラメータを使って計算する構成)は 2B / 4B / 8B / 32B、MoE(複数の専門家に分かれて計算する構成)は 30B-A3B と 235B-A22B です。
| モデル | 構成 | 公開日 |
|---|---|---|
| 235B-A22B | MoE(総 235B・1 トークンあたり 22B を活性化) | 2025-09-23 |
| 30B-A3B | MoE | 2025-10-04 |
| 4B / 8B | dense | 2025-10-15 |
| 2B / 32B | dense | 2025-10-21 |
公開日は GitHub の告知で確認できます(Qwen3-VL)。
1. abliterated 版はどれが出ているのか?#
Qwen3-VL の abliterated 版は、huihui-ai という加工元がまとめて配布しています(コレクション Qwen3-VL-abliterated、2025-12-15 更新・upvote 42)。
通常モデルの 2B・4B・8B・32B と、MoE の 30B-A3B に、それぞれ abliterated 版があります。
配布名は Instruct と Thinking の 2 系統に分かれ、同じサイズでも別のモデルとして並びます。
- 2B — Instruct / Thinking
- 4B — Instruct / Thinking / Instruct の FP8 形式(8 ビットの浮動小数点で扱う版)
- 8B — Instruct / Thinking
- 30B-A3B — Instruct / Thinking
- 32B — Instruct / Thinking
一方、MoE の最上位にあたる 235B-A22B の abliterated 版は、このコレクションにはありません(2026-10 時点では確認できません)。
同じ Qwen 系で加工元ごとの違いを比べた記事として、Qwen3.8-27B abliterated は加工元でどう違う?があります。
加工元としての huihui-ai の位置づけはhuihui-ai とは?にまとめています。
2. abliteration は画像側に何をするのか?#
配布元のモデルカードには、加工した範囲が明記されています。
8B Instruct のカードから該当箇所を引きます(Huihui-Qwen3-VL-8B-Instruct-abliterated)。
This is an uncensored version of Qwen/Qwen3-VL-8B-Instruct created with abliteration
It was only the text part that was processed, not the image part.
The abliterated model will no longer say "I can't describe or analyze this image."
(訳: これは Qwen/Qwen3-VL-8B-Instruct を abliteration で加工した検閲なし版です。加工したのはテキスト側だけで、画像側は加工していません。加工後のモデルは「この画像について説明も分析もできません」とは言わなくなります)
つまり、画像を扱う視覚側はベースモデルのままで、拒否を取り除く加工が入っているのは言語モデル側だけです。
abliteration とは、モデル内部にある「拒否の方向」を計算で見つけ、重みから取り除く加工です。仕組みはabliteration とは?で解説しています。
この加工は拒否を外すためのもので、画像の読み取りが正確になるわけではありません。
3. どのサイズを選べばよいのか?#
Ollama の配布ページには、タグごとのファイルサイズが公開されています(ollama.com/huihui_ai/qwen3-vl-abliterated)。
| タグ | ダウンロードサイズ | 備考 |
|---|---|---|
2b | 1.9GB | |
4b | 3.3GB | |
8b | 6.1GB | latest |
30b | 20GB | MoE(30B-A3B) |
32b | 21GB | dense |
| 2b | 1.9GB | |
|---|---|---|
| 4b | 3.3GB | |
| 8b | 6.1GB | |
| 30b (MoE) | 20GB | |
| 32b | 21GB |
サイズは手元のメモリに収まるかで決めます。
上の数字はモデルファイルの大きさそのものなので、必要容量の目安になります。
動かすときは会話の文脈ぶんが加わるため、余裕を見込んで選びます。
見積もりの考え方はOllama で検閲なし LLM を使うには?でまとめています。
30b と 32b は、ファイルサイズが 20GB と 21GB でほとんど同じです。
違いは構成にあります。
32B は dense で、1 トークンを出すのに 32B ぶんのパラメータを使います。
30B-A3B は MoE で、総パラメータは 30B、1 トークンあたりに活性化するのは 3B です(A の後ろの数は活性化するパラメータ数を指します)。
ファイルの大きさが近くても、計算に使うパラメータの数は違います。
同じモデルでも、量子化(数値を粗く扱ってファイルを小さくする加工)の段階ごとにファイルが分かれています。
段階の違いと選び方はGGUF の量子化とは?で解説しています。
ほかのモデルも含めた全体の選び方はuncensored モデルの選び方にまとめています。
4. Ollama・GGUF・Transformers のどれで動かせばよいのか?#
Ollama のタグで取得するか、GGUF を llama.cpp や LM Studio で使うか、Transformers や vLLM のコードから読み込むかを、使っている道具に合わせて選びます。
Ollama で動かす#
Ollama のページでは、タグを省略すると 8b が選ばれる形で配布されています。
実行は次のコマンドです。
ollama run huihui_ai/qwen3-vl-abliterated
8B Instruct のモデルカードの例では :8b-instruct のタグを付けています。
モデルカードによると、Ollama は v0.12.7 以上が必要です。
ページの表記は context 256K、入力は Text, Image、タグは vision / tools / thinking です。
ダウンロード数は 130.9K と表示されています。
GGUF で動かす#
GGUF は、llama.cpp や LM Studio といったツールで使うモデルのファイル形式です。
8B Instruct の GGUF は、huihui-ai ではなく mradermacher のページで配布されています(Huihui-Qwen3-VL-8B-Instruct-abliterated-GGUF)。
ここで注意が要るのは、本体とは別に mmproj というファイルが必要な点です。
mmproj は配布ページで "multi-modal supplement"、つまり画像を扱うための補助ファイルと説明されています。
これが無いと、モデルは画像を扱えません。
GGUF で画像も読ませるには、本体のファイルとあわせて mmproj も取得します。
mmproj は Q8_0 が 0.9GB、f16 が 1.3GB の 2 種類です。
本体の量子化ファイルは次のとおりです。
| 量子化 | サイズ |
|---|---|
| Q4_K_S | 4.80GB |
| Q4_K_M | 5.03GB |
| Q6_K | 6.73GB |
| Q8_0 | 8.71GB |
| f16 | 16.4GB |
いずれも 8B Instruct の配布ページの表記です。
ページには llama.cpp・LM Studio・Ollama の導線があり、ダウンロード数は 20,647 と表示されています。
Transformers や vLLM で動かす#
Python のコードから読み込むなら Transformers、サーバとして動かすなら vLLM が入口です。
Qwen3-VL への対応は、Transformers が 4.57.0 以上、vLLM が 0.11.0 以上で始まっています(Qwen3-VL)。
ローカルに環境を用意せず、ブラウザから画像も読ませたい場合は、Deepent Research が画像入力に対応しています(利用条件は料金ページに記載しています)。
5. つまずきやすい点は何か?#
- 画像用のファイルが無いと画像を読まない — GGUF を本体だけで取得すると、画像を読めません。mmproj も取得しているかを確認します。
- 必要容量の見積もりを間違える — 配布サイズはファイルの大きさで、動かすときには文脈ぶんが加わります。段階を上げるほどファイルも大きくなるため、f16 の 16.4GB のような数字は手元のメモリと見比べてから決めます。
- ライセンスを確認していない — 配布ページの表記は Apache 2.0 です。加工版を使うときも、配布ページで条件を確認します。
- 拒否しないことと、正確であることは別 — abliteration は拒否の方向を取り除く加工で、回答を正確にする加工ではありません。出てきた内容は使う側が確認します。
配布元は、安全フィルタが大幅に減っているため敏感な内容や不適切な内容が出る可能性があるとして、研究・実験用途を想定しています。生成した結果の責任は負わないとしています。
Deepent Research について#
私たち Deepent Research は、回答を極限まで拒否しない LLM チャットサービスです。標準の AI では途中で止まってしまう調べものを、最後まで続けられるように作りました。
- 拒否しない。LLM のガードレールを徹底的に軽減した uncensored・abliterated モデルを採用。標準の AI が「お答えできません」と打ち切る問いにも答えます(Qwen3.5 / Qwen3.8-27B-abliterated 系をプランに応じて使い分け)
- 入力は学習に使わない。調べた内容はサービス提供のためにのみ使われ、AI の学習や他の目的には使用されません。個人情報も厳重に保護し、プライバシーポリシーを公開しています
- 無料で試せる。GPU もインストールも不要、ブラウザを開くだけ。未ログインのお試しは会話が保存されないので、気軽に始められます
→ 登録なしで無料トライアル: https://deepentresearch.com
「どんな問いも、リサーチを止められない」。
No question can stop research.
よくある質問#
Qwen3-VL の abliterated 版は公式のモデルですか?#
公式のモデルではありません。
Qwen チームが公開した Qwen3-VL をもとに、huihui-ai が abliteration で加工して配布している派生版です。
どのサイズを選べばよいですか?#
手元のメモリに収まるサイズから選びます。
まず軽く試すなら 2b の 1.9GB、既定のタグになっている 8b は 6.1GB です。
20GB 以上の 30b と 32b は、置き場所とメモリに余裕があるかを確かめてから選びます。
GGUF で画像も読ませるには何が必要ですか?#
本体のファイルに加えて、mmproj という画像を扱うための補助ファイルが必要です。
mmproj は Q8_0 の 0.9GB と f16 の 1.3GB の 2 種類が配布されています。
本体だけを取得すると、画像は読めません。
235B-A22B の abliterated 版はありますか?#
2026-10 時点では確認できません。
huihui-ai のコレクションに並ぶのは 2B・4B・8B・32B と 30B-A3B で、235B-A22B の版は含まれていません。
免責#
本記事は、AI による下書きをもとに、運営が事実関係を確認・加筆・編集して公開しています。
本記事は教育・研究目的の情報提供であり、違法行為や犯罪の助長を意図するものではありません。
数値は第三者の公開レポートおよび配布元の公表値であり、測定条件により変わることがあります。
本記事の編集と検証
公式ドキュメントや論文などの一次情報と照合し、客観的な事実に基づいて整理しています。
本記事は、AI による下書きをもとに、運営が事実関係を確認・加筆・編集して公開しています。
関連ノート
検閲なし AI で文章を書くには?小説・レポートを止められずに書く手順
場面が激しい小説や、専門的なレポートの下書きで「お答えできません」と止まることがあります。検閲なし AI で書くときの設定資料の渡し方、場面を分けた書き方、文体の見本の使い方、著作権の注意を、非技術者向けに整理します。
AI が「答えられない」と言うのはなぜ?4 つの理由の見分け方と止まったときの対処
AI が断る理由は 1 つではありません。安全のための判定、情報がない、聞き方の不足、不具合や回数の上限の 4 つに分かれます。画面の表示から理由を見分けて、それぞれに合った対処をする手順と確認先を、非技術者向けに整理します。
生成 AI に任せてよいこと・いけないこと——個人情報・著作権の線引きと確認 5 項目
要約や下調べは任せられても、個人情報の入力や生成物のそのまま公開は別の話です。任せてよい作業と任せない方がよいもの、個人情報保護委員会の注意喚起と文化庁の考え方から見た注意点、会社で使うときの決め方と確認チェックリストを整理します。
この仕組みを、試す
Deepent Research は、回答を極限まで拒否しない LLM チャットサービスです。この記事で扱ったモデルと技術を、ダウンロードなしでそのまま試せます。