AI モデルの選び方——標準と高性能、6つの違いをやさしく整理
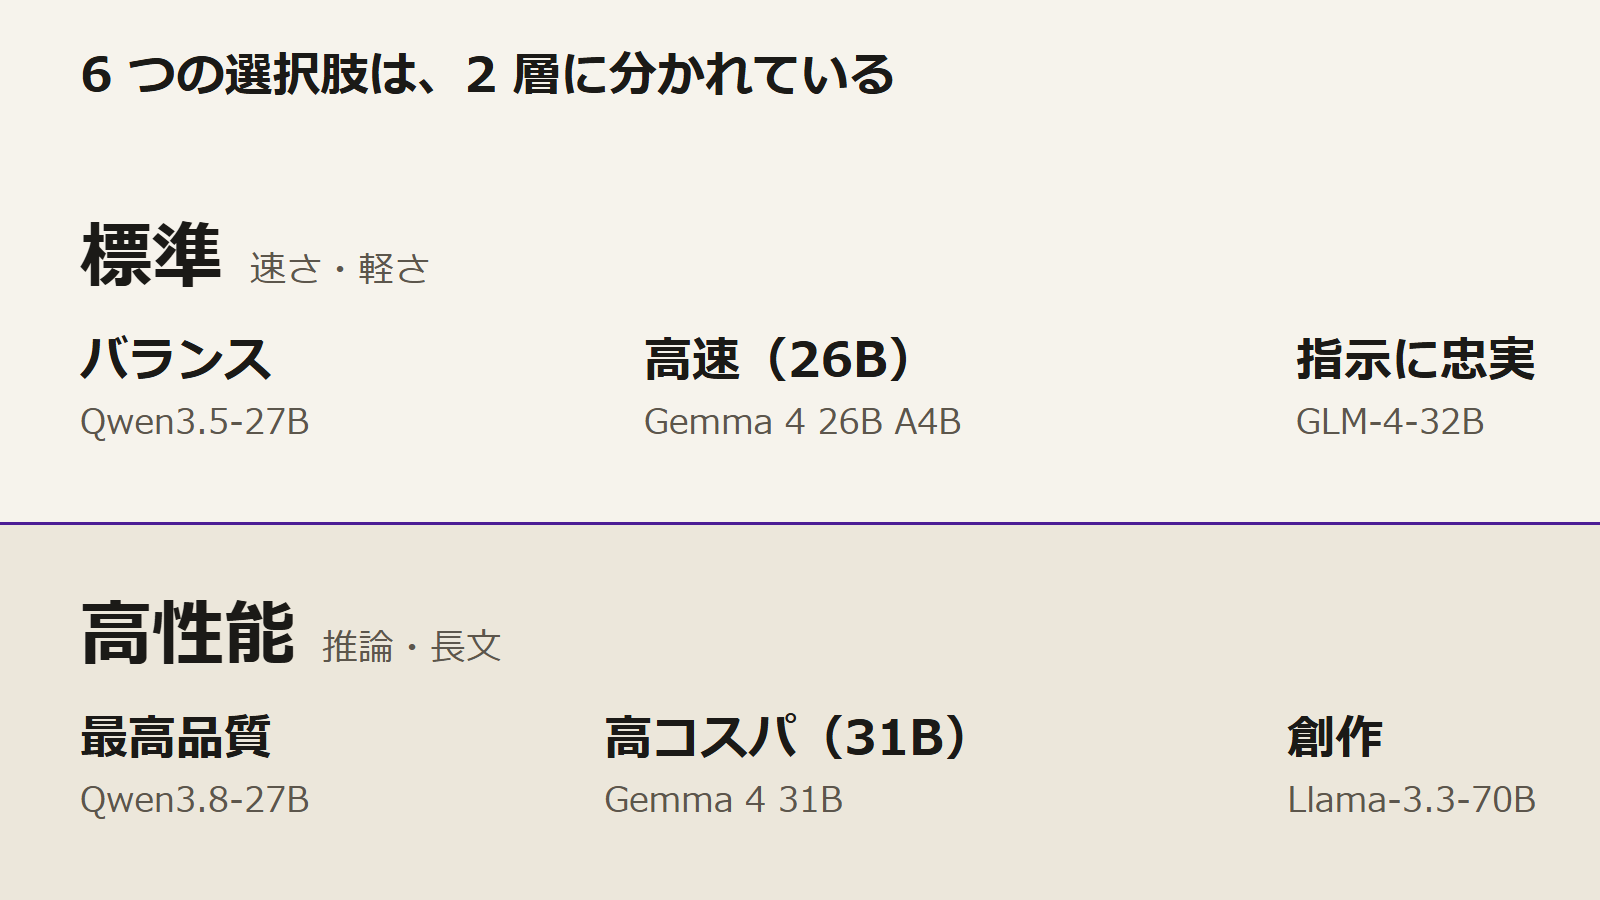
チャット画面のモデル選択で迷ったときの基準を整理します。まず標準(速さと軽さ)と高性能(推論と長文)の 2 層に分け、6 つの選択肢を「どんなときに選ぶか」で説明します。画像を送るときの注意、実モデル名の読み方、切り替えのコツまで。
対象: Deepent のモデル選択で、どれを選べばいいか迷っている人
この記事の要点
- 迷ったら既定のままで構いません。標準はバランス、高性能は最高品質が既定です。
- まず標準(速さと軽さ)と高性能(推論と長文)の 2 層で分け、細かい違いはそのあとに見ます。
- 画像を付けると、選んだモデルではなく画像対応の専用モデルに切り替わります。モデルの選択は関係ありません。
編集部の確認メモ
2026-11-13 時点で、アプリ内のモデル選択画面と料金ページ、各モデルの配布ページを確認しました。各モデルの応答品質を独自に比較したものではありません。表示名と実モデル名は変更されることがあります。
編集方針と AI の使い方 →目次
チャットの入力欄の横にモデルを選ぶ欄があり、選択肢が「標準」に 3 つ、「高性能」に 3 つで合計 6 つ並んでいます(画面に表示されるのはいま使える側の 3 つだけです)。
どれを選んでも操作方法は同じで、迷ったときは既定のまま——標準なら「バランス」、高性能なら「最高品質」——で問題ありません。切り替えが要るのは、返ってきた答えの厚みや書式が合わないと感じたときだけです。
標準と高性能の 2 層は何が違うのか#
違いは「待ち時間の短さ・軽さ」と「推論の深さ・長文処理」のバランスです。標準層は短い待ち時間で要点を返すのに向いており、高性能層は条件が入り組んだ質問の整理や長い資料の読解に向きます。
消費するクレジットも 2 層に分かれており、標準モデルは標準クレジット、高性能モデルは高性能クレジットを使います(金額と回数は 料金ページ を参照)。
標準の 3 モデルの使い分け#
いずれも待ち時間の短さを優先しつつ、得意な作業が分かれています。
- バランス(Qwen3.5-27B): 標準の既定モデル。応答の速さと質をどちらも大きく崩したくないときの基準になります。
- 高速(26B): 軽い質問や要約向き。実モデルの Gemma 4 26B A4B は、26B のうち実際に動くのが 3.8B だけの MoE(専門家切り替え構造)のため待たされにくいのが特徴です。
- 指示に忠実(GLM-4-32B): 見出しの数、箇条書きの形、出力の順番など、書式やルールを細かく守らせたいときに差が出ます。
高性能の 3 モデルの使い分け#
いずれも回答の厚みを優先しており、複雑な指示や長文処理向けです。
- 最高品質(Qwen3.8-27B): 高性能の既定モデル。推論とコーディングが強く、条件が多い質問や途中に計算が入る処理、長い資料から根拠を拾う用途に合います。
- 高コスパ(31B): 高性能の中で費用対効果を意識した選択肢で、実モデルは Gemma 4 31B(全層を使う dense 構造)。Qwen 系とは系統が異なるため、同じ質問でも答え方が変わります。
- 創作(Llama-3.3-70B): 長い文章や物語の筋を通して書き続ける用途向け。推論や計算・事実確認は Qwen や Gemma より弱いため、創作専用と割り切って使います。
用途からすぐ決める早見ルール#
- 要約や普通の下調べなら、まず「バランス」か「高速」
- コードや計算・根拠の拾い出しなら「最高品質」
- 見出しや出力形式を厳密に指定するなら「指示に忠実」
- 小説や台本を書くなら「創作」
- 日本語の自然さを優先したいなら「バランス」か「最高品質」
なお、チャット欄に画像を添付したときは選んだモデルに関係なく画像対応の専用モデルに切り替わるため、画像質問の前にモデルを選び直す必要はありません。迷ったときは標準の「バランス」へ戻り、物足りなければ高性能へ上げる、という往復で十分です。
表示名の横にある「実モデル名」の意味#
表示名は用途の目安で、横に並んでいるのが実際に動いているモデルの系統です。Qwen(Alibaba)、Gemma(Google)、GLM(Zhipu AI)、Llama(Meta)と開発元が異なり、末尾の数字がパラメータ数の目安を表します(MoE モデルは数字ほど重くなりません)。
この 6 つはいずれも拒否の反応を抑える加工(abliteration とは?)が施されています。メーカー公式の低ガードレール設計との違いは メーカー公式の『低ガードレール』モデルとは? に、自分の PC で動かす候補は Uncensored モデルおすすめ 10 選 にまとめています。
会話の途中で切り替えるコツ#
モデル変更は会話の途中でも効くため、違和感が出た時点で次の質問から切り替えれば十分です。
- 同じ質問文をそのまま別のモデルへ投げて比べる: 質問文を変えずに切り替えると、答え方の差がすぐ見えます。
- 根拠や厚みが足りないときは高性能へ移る: プロンプトに条件を足し続けるより、モデルを上げるほうが早い場面が多くあります。
- 待ち時間が気になるときは標準へ戻す: 短い質問をテンポよく重ねる作業では標準層で足ります。
よくある質問#
モデルはどれを選べばいいですか?#
迷ったら既定のまま(標準なら「バランス」、高性能なら「最高品質」)で構いません。答え方が合わないと感じたときだけ切り替えます。
画像を送るとき、モデルの選択は関係ありますか?#
関係ありません。画像を添付したターンは、選んだテキストモデルではなく画像対応の専用モデルが動きます。
表示名と実モデル名は何が違いますか?#
表示名は用途の分かりやすいラベル、実モデル名は裏側で動いているモデルの正体です。同じ高性能でも実モデル名の系統(Qwen / Gemma / Llama)によって得意分野が異なります。
この仕組みを、試す
Deepent Research は、回答を極限まで拒否しない LLM チャットサービスです。この記事で扱ったモデルと技術を、ダウンロードなしでそのまま試せます。
本記事は教育・研究目的の情報提供です。違法行為や犯罪の助長を意図するものではありません。
本記事の編集と検証
編集部が一次情報の原文を確認し、事実関係を整理して公開しています。確認した範囲と、確認していない範囲は記事中の「編集部の確認メモ」に書いています。
関連ノート
Uncensoredモデル おすすめ10選【2026年版】GPUメモリ別 uncensored LLM の選び方
2026 年の uncensored モデル(uncensored LLM)は Qwen 系の abliterated が主流です。GPU メモリ別におすすめ10モデルを比較し、uncensored と abliterated の違いと選び方、動かし方まで解説します。
abliteration(アブリテレーション)とは?「拒否しない AI」を作る仕組みをやさしく解説
abliteration(アブリテレーション)とは、AI が回答を拒む反応を打ち消して、学んだ知識はそのままに拒否だけを外す技術です。なぜ AI は答える前に止まるのか、仕組み、変わる点、注意点、よくある誤解までやさしく解説します。
メーカー公式の『低ガードレール』モデルとは?Meta・Google・Mistral・DeepSeek を3つの型で整理
大手メーカーが公開する「低ガードレール」なモデルを、分離型・素の重み+利用時ポリシー型・同じ重み・違う運用型の 3 つに分けて整理します。Meta・Google・Mistral・DeepSeek を例に、uncensored モデルとの違いと選ぶときの確認点を解説します。